FindR Algoritmasının Arazi Üzerinde Çalışma Modeli
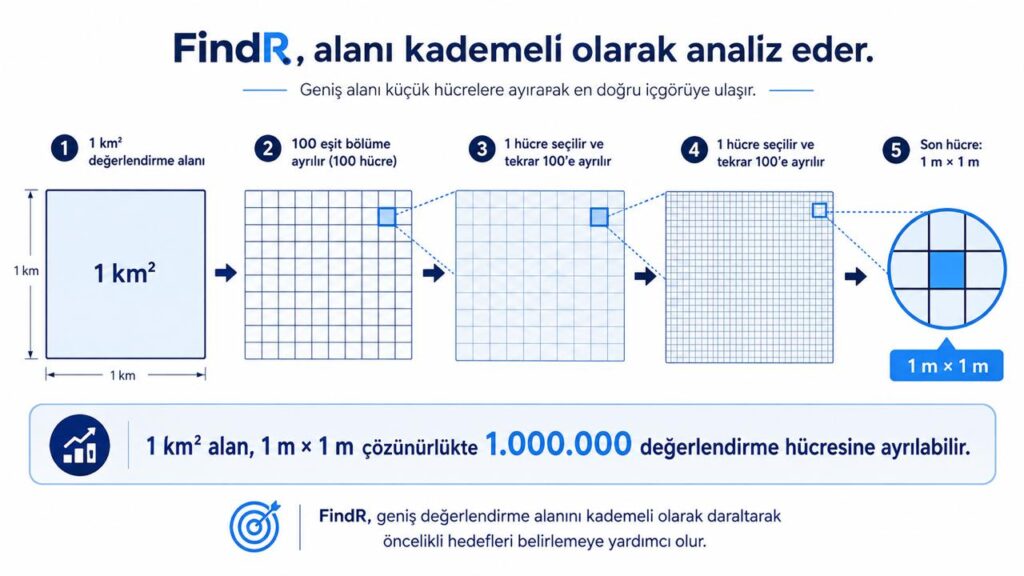
FindR algoritmasının bir arazi üzerinde nasıl çalıştığını görsel olarak açıklamak için 1 km² büyüklüğünde bir arama sahası örnek olarak ele alınabilir.
Sistem, bu alanı yüksek çözünürlüklü bir grid yapısına dönüştürerek çok sayıda bağımsız değerlendirme hücresine ayırır. Örneğin teorik olarak 1 metre çözünürlükte bir grid kullanılması halinde 1 km²’lik alan yaklaşık 1 milyon ayrı grid hücresinden oluşabilir.
Buradaki amaç yalnızca alanı geometrik olarak bölmek değildir. Her bir hücre, kendi konumuna karşılık gelen mevcut verilerin oluşturduğu çok boyutlu bir veri profili olarak değerlendirilir.
Her değerlendirme noktası veya hücresi için mevcut olduğu ölçüde:
* jeolojik,
* litolojik,
* jeokimyasal,
* fiziksel,
* kimyasal,
* yüzey,
* toprak,
* sondaj,
* laboratuvar,
* ve hedef kaynakla ilişkili diğer ölçülebilir parametreler
bir araya getirilerek o konumun karakteristik veri profili oluşturulur.
Bu profil daha sonra FindR’ın geniş tarihsel referans veri bankası içerisindeki başarılı ve başarısız arama sonuçlarıyla karşılaştırılır.
Yaklaşık 30 yıllık tarihsel veri birikiminin oluşturduğu referans popülasyonu, algoritmaya yalnızca kaynak bulunan ortamları değil, aynı zamanda kaynak bulunamayan, ekonomik olmayan veya beklenen sonucu vermeyen ortamları da karşılaştırma imkânı sağlar.
Bu nedenle algoritma her bir konum için yalnızca:
“Bu nokta geçmişte başarılı olmuş bir alana benziyor mu?”
sorusunu sormaz.
Aynı zamanda:
“Bu nokta benzer görünen ancak geçmişte başarısız olmuş hangi ortamlarla da benzerlik taşıyor?”
sorusunu da değerlendirir.
Bu iki yönlü karşılaştırma, FindR’ın hedef önceliklendirme yaklaşımının temel unsurlarından biridir.
Çok Boyutlu Hesaplama Süreci
Her hücre veya değerlendirme noktası, tek bir ölçüm ya da tek bir parametre üzerinden değerlendirilmez.
FindR’ın algoritmik mimarisi, mevcut çok sayıda değişkeni birlikte değerlendirerek her konumun tarihsel referans popülasyonu içerisindeki göreceli konumunu belirlemeye çalışır.
Bu süreç içerisinde:
Ham ve tarihsel veriler → Veri temizleme → Standardizasyon → Özellik oluşturma → Çok boyutlu özellik profili → Tarihsel analoglarla karşılaştırma → Pozitif ve negatif sonuç analizi → Değişken ağırlıklandırma → Benzerlik analizi → Mekânsal değerlendirme → Hedef önceliklendirme
gibi birden fazla analitik aşama uygulanır.
Dolayısıyla ortaya çıkan sonuç basit bir “harita taraması” değildir. Çok sayıda tarihsel gözlemin ve veri katmanının aynı analitik çerçevede değerlendirilmesini gerektiren yüksek boyutlu ve iteratif bir hesaplama sürecidir.
Bu sürecin kapsamı ve kullanılan tarihsel veri setinin büyüklüğü nedeniyle, bir projenin algoritmik analizinin sonuçlandırılması yaklaşık 3 ila 8 hafta sürebilmektedir.
Alanın Kademeli Olarak Daraltılması
Algoritmanın amacı 1 km²’lik alan içerisindeki bütün noktaları aynı öncelikte kabul etmek değildir.
İlk aşamada bütün alan geniş bir aday uzayı olarak değerlendirilir.
Daha sonra tarihsel benzerlikler, pozitif ve negatif sonuçlarla ilişkiler ve diğer değişkenlerin birleşik etkileri dikkate alınarak alan içerisinde daha yüksek öncelikli bölgeler belirlenir.
Bu süreç kademeli olarak:
1 km² Arama Sahası
↓
Yüksek çözünürlüklü grid / yüz binlerce veya yaklaşık 1 milyon değerlendirme hücresi
↓
Her hücrenin çok boyutlu veri profili
↓
Yaklaşık 30 yıllık tarihsel referans veri bankasıyla karşılaştırma
↓
Başarılı + başarısız tarihsel analogların birlikte değerlendirilmesi
↓
Çok boyutlu benzerlik ve hedef önceliklendirme analizi
↓
Haftalar sürebilen kapsamlı algoritmik hesaplama
↓
Öncelikli bölge ve hedeflerin belirlenmesi
↓
Yüksek öncelikli araştırma alanlarının daraltılması
↓
“Konvansiyonel jeolojik, jeofizik ve sondaj çalışmaları sonucunda ortaya çıkarılmış potansiyel rezervuar alanlarının FindR tarafından değerlendirilmesi ve sınıflandırılması”
şeklinde görselleştirilebilir.
Görselde Verilmek İstenen Ana Mesaj
Grafikte özellikle vurgulanması gereken nokta, FindR’ın yalnızca birkaç seçilmiş noktaya bakarak sonuç üretmediğidir.
FindR, geniş bir arama alanını yüksek çözünürlükte çok sayıda değerlendirme hücresine ayırarak, her konumun mevcut çok boyutlu veri profilini tarihsel başarılı ve başarısız arama ortamlarıyla karşılaştırır ve ardından geniş alan içerisindeki en güçlü hedefleri kademeli olarak öne çıkarır.
Böylece büyük bir arama ruhsatı veya saha, tek seferde tek bir sondaj noktasına indirgenmez. Bunun yerine algoritma, geniş alandan dar hedef alanlara ve nihayetinde öncelikli araştırma veya sondaj lokasyonlarına doğru ilerleyen hiyerarşik bir hedefleme süreci oluşturur.
Teknolojik Ölçeklenebilirlik
Bu yaklaşımın teorik hesaplama yükü, değerlendirme çözünürlüğü ve kullanılabilecek değişken sayısı arttıkça önemli ölçüde büyüyebilir.
Örneğin 1 km²’lik bir alanın 1 metre çözünürlükte yaklaşık 1 milyon hücreye ayrılması ve her hücrenin yüzlerce veya daha fazla değişken üzerinden tarihsel referans popülasyonlarıyla karşılaştırılması, klasik anlamda basit bir harita analizinden çok daha büyük bir hesaplama problemine dönüşebilir.
FindR’ın uzun vadeli teknoloji vizyonu, bu tür yüksek boyutlu hesaplama problemlerinin gelişmiş yapay zekâ, yüksek performanslı hesaplama ve gelecekte olgunlaşması beklenen kuantum hesaplama teknolojileri ile çok daha kısa sürelerde gerçekleştirilebilmesidir.
Bugün haftalar sürebilen kapsamlı hesaplama süreçlerinin gelecekte, kullanılan veri yapısı ve problem sınıfına bağlı olarak günler, hatta bazı hesaplama senaryolarında saatler seviyesine indirilebilmesi öngörülmektedir.
Bu nedenle FindR’ın teknolojik vizyonu yalnızca daha fazla veri kullanmak değil; daha büyük veri evrenlerini, daha yüksek mekânsal çözünürlükte ve daha karmaşık çok boyutlu ilişkiler üzerinden hesaplayabilecek ölçeklenebilir bir analitik mimari oluşturmak üzerine kuruludur.